Apprendre le quantique avec l’IA : quand le logiciel devient la trace de ce qu’on comprend
 Improba Lab
Au départ, il y avait une envie assez simple : apprendre à programmer en informatique quantique.
Pas pour répondre à un besoin client, ni pour lancer un nouveau produit. Plutôt par curiosité, à la croisée de deux parcours que nous connaissons bien chez Improba : la modélisation scientifique et le développement logiciel.
Le problème avec l'informatique quantique, c'est qu'on arrive assez vite dans un univers où lire ne suffit plus tout à fait. On peut manipuler les équations, apprendre ce qu'est un qubit, découvrir les opérations de base ou la façon dont une mesure fonctionne. Mais entre « je peux répéter la définition » et « je crois avoir compris ce qui se passe », il reste un espace assez large, dans lequel on se raconte souvent qu'on a compris alors qu'on a surtout appris à parler comme quelqu'un qui a compris.
Un membre de l'équipe a donc commencé une expérimentation interne avec une idée : utiliser l'IA non pas seulement pour se faire expliquer l'informatique quantique, mais pour construire progressivement son propre dispositif d'apprentissage.
Le projet qui en résulte est encore jeune. Il est publié en open source sur GitHub. Il y a une partie cours, des exercices pour vérifier qu'on a compris, des travaux pratiques sur un simulateur, et progressivement une application qui permet de voir à l'écran les phénomènes qu'on est en train d'étudier.
Mais en discutant de cette expérimentation, nous nous sommes rendu compte que le plus intéressant n'était peut-être pas l'application elle-même. C'était la manière dont elle se construisait, et ce que cette manière dit de l'apprentissage avec une IA : sa force, et ce qu'elle laisse dans l'ombre.
Ne pas laisser l'IA nous faire sauter les étapes
Lorsqu'on utilise ChatGPT ou un autre modèle pour apprendre quelque chose, la tentation est forte d'aller directement à ce qui nous intéresse. On pose une question, on obtient une explication, on demande un exemple, puis du code, puis une interface. Quelques minutes plus tard, quelque chose fonctionne à l'écran, et on ressent cette satisfaction familière : on a avancé.
Reste une question légèrement désagréable : qu'est-ce qu'on a réellement compris ?
L'expérience a donc commencé par l'établissement de règles. Le cursus est découpé en modules. Dans chacun d'eux, l'IA produit et adapte un cours, puis pose des questions qui permettent de vérifier la compréhension. Le travail pratique ne vient qu'ensuite, et l'interface de visualisation n'est développée qu'une fois ce travail pratique lui-même compris. Autrement dit, la partie la plus gratifiante, celle où l'on voit enfin quelque chose bouger à l'écran, est volontairement repoussée.
L'objectif n'est pas d'empêcher l'IA de produire du code. C'est presque l'inverse : puisqu'elle sait le faire très vite, il faut se donner des garde-fous pour éviter qu'elle fasse disparaître l'effort intellectuel que l'on cherchait précisément à accomplir.
Dans un apprentissage traditionnel, ce garde-fou existe naturellement. Un enseignant choisit l'ordre des notions, impose des exercices, revient sur un point mal compris. Avec une IA disponible en permanence et capable de répondre à presque toutes les demandes, cette structure doit être reconstruite explicitement. Sinon le modèle fait ce pour quoi il est très bon : produire une suite cohérente, utile, et trop tôt achevée.
Une partie du travail ne consiste plus à accéder à l'information, mais à organiser les conditions dans lesquelles on accepte d'y accéder.
Si l'on demande trop tôt l'interface, on obtient un objet qui fonctionne, une chose qui a l'air finie, et il devient très facile de confondre cette apparence avec la compréhension. Les règles du cursus servent surtout à retarder ce moment.
Voir un qubit plutôt que seulement le calculer
Cette logique prend tout son sens avec la mécanique quantique, parce qu'une grande partie de la difficulté vient de notions que nous manipulons mal intuitivement. Un objet peut être dans plusieurs états à la fois, jusqu'à ce qu'on le mesure. Le mesurer, ce n'est pas simplement le regarder, cela change ce qu'il est. On peut écrire tout cela correctement dans un cahier, sans que rien, dans l'expérience quotidienne, ne vienne vraiment l'étayer.
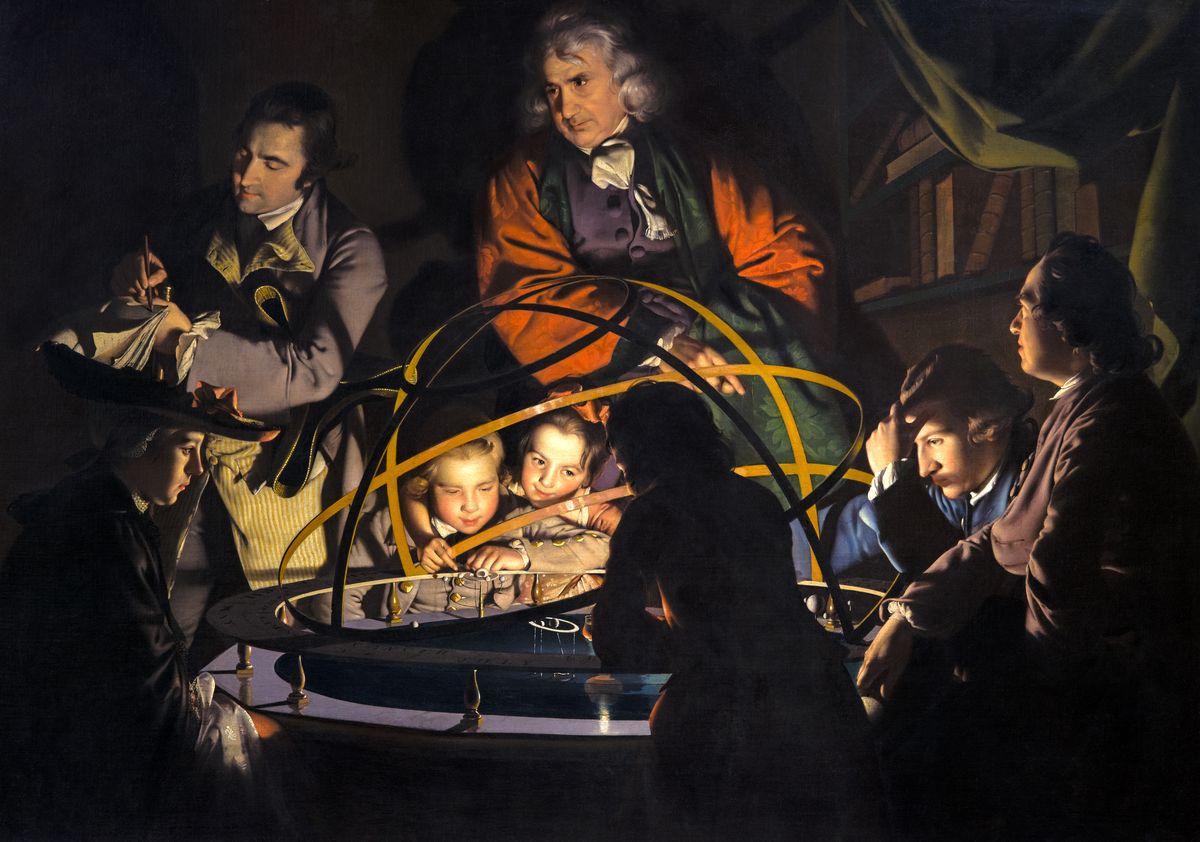
L'application développée au fil de l'apprentissage sert justement à rendre ces notions visibles. C'est le même geste que le planétaire de la couverture : on ne contemple pas le ciel, on construit un objet qui en porte la trace, et l'on apprend en le faisant tourner.
À l'état actuel du projet, elle permet notamment de manipuler un qubit et de représenter son état sur une sphère de Bloch, une sorte de globe qui donne une forme à ce que les équations décrivent. On peut modifier différents paramètres, observer comment l'état se déplace à la surface de cette sphère, repérer quelques configurations particulières, ou appliquer les opérations de base de l'informatique quantique et regarder comment l'état évolue.
Ce n'est évidemment pas une représentation littérale d'un objet quantique posé quelque part dans l'espace. C'est une manière de donner une forme géométrique à des objets mathématiques qui, autrement, resteraient essentiellement dans des équations. La sphère n'est pas le qubit. Elle est un accord provisoire entre ce que les maths disent et ce que l'œil peut suivre.
Et dès qu'on commence à manipuler cette représentation, certaines propriétés deviennent beaucoup plus concrètes, à commencer par la mesure. Une fois un état quantique mesuré, on ne peut pas simplement continuer à le regarder sous tous les angles, comme s'il s'agissait d'un objet classique posé sur une table. Pour observer la distribution des résultats, il faut préparer à nouveau le système, reproduire l'expérience, mesurer, recommencer. Le logiciel force ce geste. Il empêche de « regarder encore un peu » ce qui a déjà été mesuré, et cette contrainte, un peu frustrante, est précisément ce qu'il y a à comprendre.
L'application rend le processus sensible : préparer un état, construire un petit circuit, effectuer une mesure, recommencer suffisamment de fois pour voir apparaître les probabilités. On peut également commencer à introduire du bruit, ou un léger décalage dans l'état, et constater ce que cela change.
Sur le papier, tout cela peut évidemment être décrit mathématiquement. Mais pouvoir modifier un paramètre et voir immédiatement la représentation évoluer apporte autre chose. Il y a un rapport presque expérimental au concept, même lorsque l'expérience elle-même reste simulée. C'était d'ailleurs l'objectif formulé au départ : pouvoir « toucher du doigt » ce qui se passe.
Une application qui représente ce qu'on a compris
C'est pendant une discussion autour du projet que nous avons réalisé quelque chose d'un peu plus étrange. L'application n'a pas été conçue à l'avance. Elle progresse en même temps que le cours.
Lorsqu'une nouvelle notion est comprise, elle peut être représentée ou manipulée dans l'interface. Lorsque le cursus avance, de nouvelles fonctions apparaissent. Et quand une notion reste floue, le développement est volontairement retardé, non pas par manque de temps, mais par discipline : ajouter trop tôt une visualisation, ce serait donner au logiciel une avance sur celui qui l'écrit.
L'état du logiciel devient donc, d'une certaine manière, une représentation de l'état de compréhension de son auteur.
Si l'on voulait savoir jusqu'où l'apprentissage a progressé, on pourrait presque demander à voir la version actuelle de l'application.
Les concepts que l'on sait manipuler y sont présents. Ceux qui n'ont pas encore été étudiés ne le sont pas. Certaines visualisations témoignent des questions qui ont été posées en cours de route. On pourrait presque lire l'interface comme on lit un paysage : ce bouton existe parce qu'une question a été posée, cette absence existe parce qu'un chapitre n'a pas encore été traversé, et ce qui n'est pas dans le logiciel renseigne autant que ce qui y est.
Le logiciel devient une sorte de trace matérielle de l'apprentissage, moins un projet final qu'un carnet de laboratoire que l'on pourrait faire tourner. Et c'est là que l'expérience dépasse, à notre avis, le cas de l'informatique quantique. On pourrait imaginer le même mécanisme dans de nombreux domaines où comprendre implique de construire une représentation : une simulation physique, des statistiques, de l'électronique, de la mécanique, de la géométrie, du traitement du signal, peut-être même certains domaines moins techniques.
Traditionnellement, on apprend d'abord, puis on réalise un projet censé mobiliser ce que l'on a appris. Ici, les deux progressent ensemble. Le projet n'est plus seulement l'exercice final. Il devient le miroir du chemin parcouru.
Un cours qui finit par devenir très personnel
L'autre conséquence est plus subtile. Au fil des échanges, le cours généré par l'IA s'éloigne progressivement d'un cursus standard. Quand une notion est mal comprise, elle est reformulée. Quand une question apparaît, une branche supplémentaire se crée. Quand une manipulation semble utile pour vérifier une intuition, elle peut être intégrée au travail pratique ou à l'application.
Le résultat finit donc par ressembler à un cours construit pour une seule personne, à partir de ses incompréhensions, de ses curiosités et de son rythme.
C'est probablement l'une des choses les plus puissantes que les modèles actuels apportent à l'apprentissage. Pendant longtemps, la personnalisation d'un enseignement était limitée par le temps disponible d'un enseignant : un professeur ne peut pas écrire un cursus différent pour chaque étudiant, répondre sans limite à chaque question et reformuler dix fois une notion de dix manières différentes. Une IA, elle, peut le faire.
Mais cette personnalisation inverse aussi, silencieusement, une habitude ancienne. Dans un cours classique, c'est souvent l'enseignant qui interroge, et l'étudiant qui révèle, par ses réponses, ce qu'il n'a pas vu. Ici, c'est l'apprenant qui pose les questions. Le modèle répond, s'adapte, approfondit ce qui a été demandé. La conversation devient très juste, et en même temps très étroite, parce qu'elle ne couvre que ce que l'on a pensé à demander.
Si le cours se construit à partir des questions que je pose, qu'arrive-t-il aux questions que je ne pense pas à poser ?
Le problème des angles morts
C'est probablement le point sur lequel nous sommes aujourd'hui les plus prudents. Un dialogue avec une IA peut devenir extrêmement cohérent. Elle connaît le chemin suivi, les questions précédentes, les notions qui ont posé problème, et elle peut s'adapter en permanence. Mais justement, elle suit ce chemin.
L'apprenant et l'IA peuvent progressivement construire ensemble une représentation cohérente d'un sujet, tout en laissant de côté un élément important que ni l'un ni l'autre n'a fait apparaître dans la conversation. Le danger n'est pas seulement l'erreur factuelle, que l'on peut encore corriger en recoupant. C'est l'erreur invisible : une image mentale qui se tient, qui marche tant qu'on reste dans ce qu'on a déjà vu, et qui n'a jamais été vraiment mise à l'épreuve.
Une IA est entraînée à poursuivre un texte de manière cohérente, et c'est une qualité dans une conversation. C'est aussi un défaut pour apprendre. Comprendre, en science, demande souvent de casser une représentation trop confortable. Le modèle, lui, n'a aucune raison de briser une image qui satisfait l'apprenant, si personne ne l'y invite. Les angles morts ne viennent donc pas seulement d'une consigne mal écrite. Ils tiennent à la manière dont l'outil fonctionne.
Dans un domaine scientifique, le problème est loin d'être anecdotique. Les ressources utilisées dans cette expérimentation s'appuient notamment sur des références académiques et des supports reconnus, par exemple ceux d'IBM sur l'informatique quantique. Mais cela ne dispense évidemment pas de vérifier ce que produit le modèle, et surtout cela ne répond pas entièrement au problème du regard extérieur.
Nous avons essayé d'imaginer où placer un spécialiste humain dans ce dispositif. La première réponse est évidente : vérifier le contenu et répondre aux questions difficiles. Mais son rôle pourrait être plus intéressant ailleurs. Un expert peut regarder le chemin emprunté et demander : « Pourquoi n'as-tu pas essayé ça ? » Il peut proposer une expérience que l'apprenant n'aurait pas imaginée, pointer une simplification devenue trompeuse, faire le lien avec une notion située trois chapitres plus loin, ou simplement repérer qu'un raisonnement paraît parfaitement cohérent parce que tout le monde, IA comprise, a accepté la même hypothèse de départ.
Plus l'IA devient bonne pour accompagner un raisonnement, plus cette fonction de contradiction extérieure nous paraît importante : moins transmettre toute l'information, davantage regarder le chemin emprunté, identifier les angles morts, et pousser l'apprentissage là où ni l'étudiant ni l'IA ne seraient allés seuls. Le rôle du professeur ou de l'expert ne disparaît donc pas nécessairement, il se déplace. Il ressemble moins à celui d'un cours magistral qu'à celui d'un relecteur de thèse : quelqu'un qui n'a pas suivi la conversation, et qui, pour cette raison même, voit ce que la conversation a cessé de voir.
Et si le vrai projet était la méthode ?
Nous pensions initialement que le résultat naturel de cette expérimentation serait l'application. Peut-être qu'elle sera publiée un jour, mais ce n'est finalement pas forcément la partie la plus intéressante à partager. Car récupérer l'application terminée reviendrait à récupérer le résultat de l'apprentissage de quelqu'un d'autre, déjà abouti, déjà fermé sur lui-même.
Ce qui nous intéresse davantage serait de permettre de reproduire le processus.
Une grande partie du dispositif est déjà décrite sous forme de fichiers de notes, en Markdown : structure du cursus, règles de progression, instructions données à l'IA, organisation des modules et des exercices. Quelqu'un peut récupérer cet ensemble de règles, choisir un sujet et tenter la même expérience, pas nécessairement pour obtenir le même logiciel, au contraire. Si la méthode fonctionne, deux personnes partant du même cadre devraient progressivement produire deux parcours différents, façonnés par leurs questions et leur manière de comprendre.
C'est cette partie que nous commençons à partager, progressivement, dans le dépôt github.com/Improba/teach-quantum. Cela soulève au passage une question sur la manière dont nous partageons les projets qui utilisent l'IA. Dans le logiciel open source classique, on partage principalement du code. Avec ce type d'expérience, une partie essentielle du projet se trouve ailleurs : dans les instructions, les règles, le contexte, les étapes de validation, les documents qui organisent le dialogue entre l'humain et le modèle.
En science expérimentale, on ne publie pas seulement la courbe. On publie aussi la méthode, pour qu'un autre laboratoire puisse recommencer, éventuellement échouer autrement, et que l'expérience reste néanmoins la même. Publier ces fichiers de notes, les règles, les consignes données au modèle, c'est ce geste-là. Le code de l'application, lui, serait la compréhension d'une seule personne, figée.
Ce qu'il faudrait partager pour que quelqu'un d'autre puisse recommencer n'est donc peut-être plus seulement le programme. C'est aussi la méthode qui permet de le faire émerger.
Ce que nous en retenons pour l'instant
L'expérience est encore au début, ce qui est plutôt une bonne raison d'en parler maintenant : nous ne savons pas encore exactement où elle mènera. L'application va continuer à évoluer avec l'apprentissage de l'informatique quantique. Certaines intuitions décrites ici se révéleront probablement moins intéressantes que prévu. D'autres apparaîtront en cours de route.
Mais une idée nous semble déjà mériter d'être explorée. On parle beaucoup de l'IA comme d'un moyen d'accéder plus rapidement à la connaissance. C'est vrai, mais ce n'est peut-être pas le changement le plus profond. Ce qui devient possible, c'est de construire un environnement d'apprentissage qui réagit en permanence à ce que l'on comprend, à ce que l'on ne comprend pas, et aux objets que l'on crée pour rendre cette compréhension visible.
Le risque est alors paradoxal : aller tellement vite que l'on confonde la capacité de l'IA à produire une réponse avec notre propre capacité à la comprendre. D'où l'intérêt, peut-être, de lui demander parfois de faire exactement le contraire de ce pour quoi on l'utilise habituellement : nous empêcher d'aller trop vite.
La prochaine étape sera de voir si cette méthode résiste à quelque chose d'essentiel en science comme en ingénierie : un regard extérieur. Et si elle peut être reproduite par quelqu'un d'autre, sur un autre sujet, avec un chemin totalement différent.